
什么是键值缓存(KV Cache) – AI百科知识
发布于 2026-11-04 · 键值缓存(Key-Value Cache,简称 KV Cache)是 Transformer 架构大语言模型在自回归推理阶段的核心优化技术。通过将先前已计算的历史词元键(Key)和值(Value)张量持久保存在显存中,模型在逐词生成新词时无需对全文进行二次冗余计算,从而将推理计算复杂度从平方级降低至线性级。它直接决定了模型的生成速度与单卡显存吞吐瓶颈。
键值缓存(Key-Value Cache,通常简称 KV Cache)是基于 Transformer 架构的大语言模型(LLM)在推理阶段必不可少的核心加速机制。大模型在输出文本时采用“自回归”机制,即每次前向传播只能计算并生成一个新词元(Token)。若没有缓存,每生成一个新词元都需要将之前所有的历史上下文重新计算一次注意力权重,导致计算量随文本长度呈平方级爆炸。KV Cache 的设计思想非常直观:用显存换算力,将所有历史词元对应的键(Key)和值(Value)向量保存在 GPU 显存中,使得后续每次生成只需对新词元计算一次投影,从而将推理时间复杂度降低为线性级。然而,KV Cache 也带来了巨大的显存开销,成为限制大模型并发吞吐与超长上下文处理的核心物理瓶颈。
什么是键值缓存
键值缓存(Key-Value Cache,KV Cache)是深度学习中专门针对自注意力机制(Self-Attention)设计的动态中间激活状态缓存。
在标准的 Transformer 自注意力计算中,每个词元通过线性投影矩阵分别得到查询向量 Q、键向量 K 和值向量 V。其中,Q 表达“当前词在找什么”,K 表达“上下文词包含什么索引”,V 表达“上下文词包含的具体特征内容”。通过计算 Q 与所有上下文 K 的点积注意力分数,并对 V 进行加权求和,即可得出当前词的综合表示。
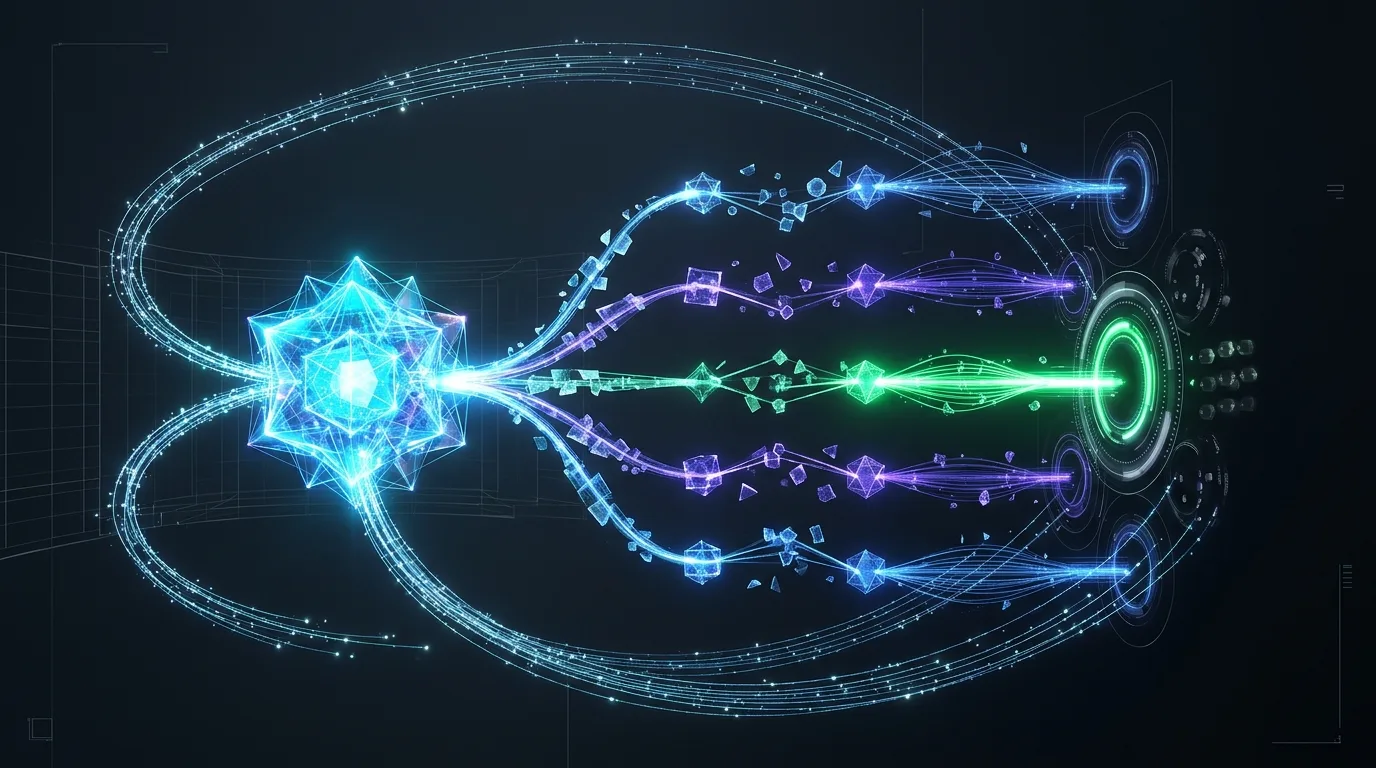
在自回归文本生成任务中,模型推理被严格划分为两个阶段:预填充阶段(Prefill Phase)与解码阶段(Decode Phase)。在 Prefill 阶段,模型并行读取用户输入的全部提示词并生成首个输出词;而在随后的逐词解码阶段,因果注意力掩码(Causal Mask)保证了每一个新词只能看到它前面的历史词元。这意味着已经生成的所有历史词元在各 Transformer 层中的 K 和 V 向量是完全静态恒定的。因此,只要将这些中间向量永久保留在显存中,当前新词生成时就只需计算单步词元的 Q 向量并与显存里的历史 K、V 交互,而无需对整个上下文历史做重复矩阵投影。这一机制正是键值缓存。
键值缓存的工作原理
一个标准的带有 KV Cache 的自回归推理前向迭代主要包含以下四个核心环节:
- 初始张量持久化(Prefill Caching):在预填充提示词阶段结束时,系统将各 Transformer 层由输入序列计算出的 Key 和 Value 矩阵,按层数、注意力头与序列长度维度整体存入显存专有缓冲区。
- 单步增量投影(Incremental Query Projection):进入解码阶段后,模型每次仅输入上一步刚刚生成的单个 Token,仅对该 Token 进行一次线性投影得到其单步 Q_new、K_new 与 V_new,免去对先前 N 个历史词元的冗余特征计算。
- 缓存拼接与注意力运算(Cache Appending & Attention):将新产生的 K_new 与 V_new 动态追加到显存缓冲区的历史 K_cache 与 V_cache 序列末尾;随后仅使用单步 Q_new 与全量增量后的 Key 向量做点积注意力计算并加权 Value,整体计算复杂度由 O(N^2) 降至 O(N)。
- 显存占用定量核算(Memory Footprint Calculation):每个词元在每层都需要分别保存 Key 和 Value 两个张量。在常见的 16 位浮点精度(FP16/BF16,每数值占 2 字节)下,单 Token 占用的显存字节数为:2 × 2 × 层数 × 隐藏维度。以 70B 模型(80 层、隐藏维度 8192)为例,单个上下文长度为 1000 的请求即需占用约 2.6 GB 显存;在 128k 超长上下文或多路并发场景下,KV Cache 所占显存往往迅速超越模型权重本身。
正是因为这种计算与显存的权衡,现代大模型推理框架几乎全部围绕 KV Cache 的高效分配、传输与复用展开工程演进。
键值缓存的主要应用
- 高吞吐推理调度服务:以 vLLM 为代表的现代推理框架提出了 PagedAttention 机制,借鉴操作系统的虚拟内存分页思想,将原本连续存储的 KV Cache 离散化为固定物理内存页,将显存碎片率从传统框架的 60%~80% 压降至 4% 以下,大幅提升了 GPU 的并发承载上限。
- 多轮对话与智能体前缀共享:在 Agent 自动化调用与长对话系统中,系统提示词(System Prompt)和公共历史文档保持稳定。通过前缀缓存(Prompt / Prefix Caching)技术,服务端可直接跨请求复用已有的 KV Cache,避免每次请求重复进行耗时的 Prefill 预填充。
- 模型架构原生轻量化(GQA / MQA):现代前沿开源模型(如 Llama 3、Mistral、Qwen、DeepSeek)普遍采用分组查询注意力(Grouped-Query Attention)与多查询注意力(Multi-Query Attention),使多个 Query 头共享单一组 Key-Value 头,直接将 KV Cache 显存体积裁剪为原来的 1/4 到 1/8。
- 端侧与边缘设备部署:在个人 PC、手机与终端设备上(如 Ollama、llama.cpp、MLC-LLM),通过对 KV Cache 引入低比特量化(INT8、INT4 乃至 FP8),能够在极轻微精度损耗的前提下将显存占用再降半数以上,使消费级显卡顺畅跑通万级别长上下文任务。
- 推测解码与树状解码支持:在投机采样(Speculative Decoding)与并行解码算法中,草稿模型预测的多分支词元在验证未命中时需要快速丢弃分支并回滚,KV Cache 的树状管理与零拷贝分支机制是保证加速收益落地的基石。
键值缓存面临的挑战
- “显存墙”(Memory Wall)严峻限制:上下文长度扩展至 128K、1M 乃至更大时,单请求所需的 KV 显存成倍膨胀,单卡甚至单机集群显存迅速告罄,迫使系统大幅降低批处理(Batch Size)大小,导致 GPU 张量计算核心长时间处于饥饿等待状态。
- 动态长度不可预测与碎片分配开销:大模型在文本生成结束(遇到 EOS 终止符)前无法精确预估本次回答的长度。静态预留显存极易造成巨大闲置浪费,而实时动态重分配显存又会引入密集的 CUDA 内核等待与碎片管理开销。
- 多卡并行下的互联通信瓶颈:在长上下文并行(Context Parallelism)与张量并行(Tensor Parallelism)切分中,KV Cache 需要在多张 GPU 或多个节点之间进行跨设备切片与状态同步,集群互联带宽(如 NVLink 或 RoCE 网卡)极易成为生成速度的制约瓶颈。
- 低比特量化保真度与长程漂移:将 KV Cache 激进量化为 INT4 或 FP4 等超低比特时,部分注意力头中的离群极端数值(Outliers)极易被截断,随着生成步数增长容易产生误差累积,导致模型在数学计算与逻辑推导中产生事实幻觉。
键值缓存的未来与前景
突破 KV Cache 的物理束缚已成为大模型推理系统研发的最前沿阵地。当前的发展趋势呈现三大清晰主线:其一是超低比特与自适应稀疏量化,例如支持浮点 8 位(FP8)和自适应通道量化已成为数据中心推理卡的原生标配;其二是序列级上下文动态剪枝(KV Cache Pruning),如 StreamingLLM、SnapKV 等方案通过仅保留关键注意力下沉词元(Attention Sinks)与局部观察窗,实现近乎无上限长文本的恒定显存推理;其三是探索无二次 KV 膨胀的新型模型架构,混合状态空间模型(如 Mamba、RWKV、Jamba)通过固定维度的隐藏状态完成序列推演,有望从根本上终结生成式 AI 对海量显存缓存的依赖。
0 条评论
暂无评论,来抢沙发。