
什么是群体相对策略优化(Group Relative Policy Optimization, GRPO) – AI百科知识
发布于 2026-11-03 · 群体相对策略优化(Group Relative Policy Optimization,GRPO)是一种专为大模型推理与长思维链设计的高效强化学习算法。它通过对同一提示采样一组候选输出并基于组内相对得分标准化计算优势,彻底去除了传统 PPO 中昂贵且不稳定的 Critic 价值模型,在将显存开销降低近半的同时,支撑了 DeepSeek-R1 等强推理模型的自主思维演进。
群体相对策略优化(Group Relative Policy Optimization,简称 GRPO)是一种面向大语言模型(LLM)的高效强化学习(RL)算法,最早由 DeepSeek 团队在 DeepSeekMath 论文中提出,并在 DeepSeek-R1 系列强推理模型的训练中大放异彩。在传统的 RLHF(基于人类反馈的强化学习)中,主流算法 PPO 需要额外维护一个与主模型参数量相当的评论家模型(Critic)来评估状态价值,不仅消耗巨额显存,而且价值估计的噪声常导致训练崩溃。GRPO 的核心创新在于摒弃了 Critic 模型,转而通过对同一输入采样一组候选输出,利用组内候选的相对表现来计算优势函数,在显著节省硬件资源的同时,大幅提升了模型在数学、代码与长思维链(Chain of Thought)推理任务上的探索能力与对齐稳定性。
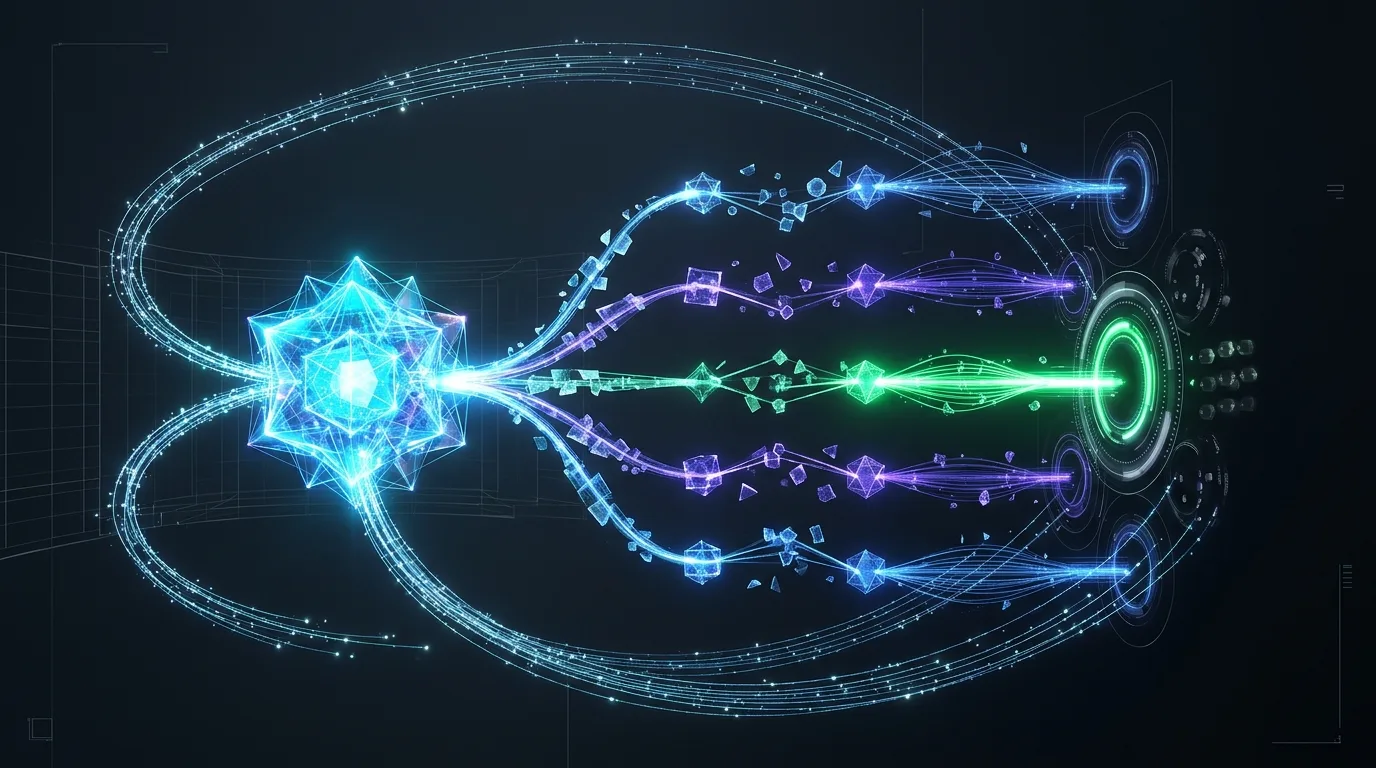
什么是群体相对策略优化
群体相对策略优化(Group Relative Policy Optimization,GRPO)是策略梯度强化学习(Policy Gradient RL)方法在现代大语言模型后训练阶段的一种关键演进。
在传统大模型强化学习体系中,PPO(Proximal Policy Optimization)是长期的行业基准。然而,将 PPO 应用于数十亿乃至数百亿参数的现代大语言模型时,面临着严苛的系统与算法瓶颈:PPO 要求同时常驻并计算四个模型——策略模型(Actor)、参考模型(Reference)、奖励模型(Reward)以及价值评论家模型(Critic)。其中,Critic 模型的参数量通常与 Actor 相当,不仅直接吃掉近一半的显存与通信带宽,而且在大模型逐词生成的复杂动态环境中,针对每一步状态准确估计全局价值极度困难,Critic 的估值漂移往往成为训练不稳定的源头。
GRPO 正是为了突破这一瓶颈而设计的。它的基本思想是:既然为每个状态单独训练绝对价值评估器成本高昂且容易失准,不如让策略模型针对同一个输入提示(Prompt)生成一个“输出群组(Group)”,然后根据规则奖励(如数学答案是否正确、代码是否通过单元测试)对这组输出进行统一打分,以组内均值作为基准线,通过组内标准化直接算出每个回答的“相对优势”。表现高于组均值的回答获得正向更新激励,低于组均值的回答受到惩罚。这种去中心化价值基线的机制,彻底解耦了对独立 Critic 模型的依赖。
群体相对策略优化的工作原理
GRPO 的训练流水线兼具数学优雅性与工程轻量性,一个标准迭代周期主要包括以下四个核心环节:
- 群组候选采样(Group Sampling):对于给定的输入提示词,策略模型(旧策略)基于特定采样温度并发生成一组(通常为 G 个,如 G = 4 到 16)候选回答。
- 多维度奖励打分(Reward Scoring):利用确定性的验证器或专门的奖励模型对这组回答分别打分,得到奖励向量。在数学与逻辑推理场景中,通常结合“结果正确性奖励(Rule-based Reward)”与“格式遵循奖励(Format Reward,如强制使用思考标签展开推理)”,无需训练复杂的神经奖励模型。
- 组内相对优势计算(Relative Advantage Estimation):计算该组所有候选奖励的均值与标准差,对每一个候选回答的奖励做 Z-score 标准化。该相对值直接作为对应候选在整个序列上的优势指标,免去了在每个词元级别反向递推价值函数的繁琐计算。
- 带截断的策略梯度更新(Clipped Policy Update & KL 惩罚):借鉴 PPO 的重要性采样比率与截断(Clipping)机制,确保新策略不会偏离旧策略过远;同时引入相对参考策略(Reference Model)的无偏 KL 散度惩罚,防止策略发生灾难性崩溃或过度拟合奖励漏洞。
相比 PPO,GRPO 将四模型架构精简为策略模型与参考模型(甚至在纯强化学习阶段可将参考模型参数冻结或分时共享),在同等显卡集群下直接省下约 50% 的显存与优化器状态开销,支持更大批次(Batch Size)或更长的上下文思维链并行训练。
群体相对策略优化的主要应用
- 大模型深度推理与思维链涌现:DeepSeek-R1-Zero 与 DeepSeek-R1 证实,在仅使用规则奖励和 GRPO 的无监督冷启动训练下,模型能自发演化出数万字的自我反思、回溯试错、重新检查等高级思考模式。
- 数学推理与符号计算:在 GSM8K、MATH 等权威基准测试中,数学问题的答案可以被精确解析与正则核验。GRPO 能通过组内探索快速强化产生正确终解的推理路径,显著提升解题成功率。
- 代码生成与单元测试驱动验证:将代码运行结果(通过编译、通过测试用例、超时报错等)直接作为奖励信号,GRPO 能够在探索不同代码实现逻辑时有效惩罚语法错误与边界用例失效,自动习得稳健的算法实现。
- 遵循复杂指令与格式规范:通过在奖励函数中设定软硬约束(例如严格输出 JSON Schema、XML 标签或指定字数结构),GRPO 可以高效对齐模型的输出排版,而无需人工标注数万条格式样本。
- 算力受限团队的端到端强化学习:由于省去了 Critic 模型的百亿参数显存与反向传播计算,中小团队乃至学术界可以在有限的 GPU 集群上复现超大规模长思考模型的全量强化学习训练。
群体相对策略优化面临的挑战
- 组内方差崩塌(Zero-Variance Problem):若针对某个高难度题目,群组内采样的所有候选回答全部回答错误(奖励皆为 0),或者针对极其简单的问题全部回答正确(奖励皆为 1),组内标准差趋向于零,导致优势计算退化失效,模型在该样本上无法获得有效梯度。
- 探索广度与采样组大小的权衡:组大小 G 直接决定了基线均值估计的鲁棒性。过小的 G(如 2 或 4)容易受离群极端值干扰;过大的 G 则会成倍拉长每轮训练的生成时间,在长序列推理场景下显著增加端侧等待延迟。
- 主观非结构化任务难以定义规则奖励:在文学创作、开放式对话或哲学讨论等缺乏唯一客观真值的领域,无法直接套用结果核验规则,仍需依赖神经网络打分模型,容易诱发奖励黑客(Reward Hacking)攻击。
- 奖励欺骗与过度冗长:在缺乏严格惩罚机制的情况下,模型可能发现“只要把回答写得极长、表面结构极复杂就能提高被判正确的概率”,从而导致无意义思维链膨胀(Reasoning Bloat)。
群体相对策略优化的未来与前景
GRPO 的提出标志着大语言模型后训练从“模仿人类示范数据(SFT)”向“自主探索进化(Verifiable RL)”的范式跃迁。未来,GRPO 的演进正沿着三个关键维度深化:一是自适应动态群组采样,根据 Prompt 难度动态调整采样组规模与温度,避免方差崩塌;二是与过程奖励模型(PRM)和测试时搜索(Test-Time Search)的深度融合,将序列级的相对优势进一步向关键推理步骤细化;三是向多模态与通用智能体(Agent)环境迁移,将环境交互步骤的即时反馈纳入群组相对比较,成为构建具备长程规划与自我修正能力的下一代通用推理系统的基础底层架构。
0 条评论
暂无评论,来抢沙发。