

什么是 PubMedQA?(平台定位与核心价值)
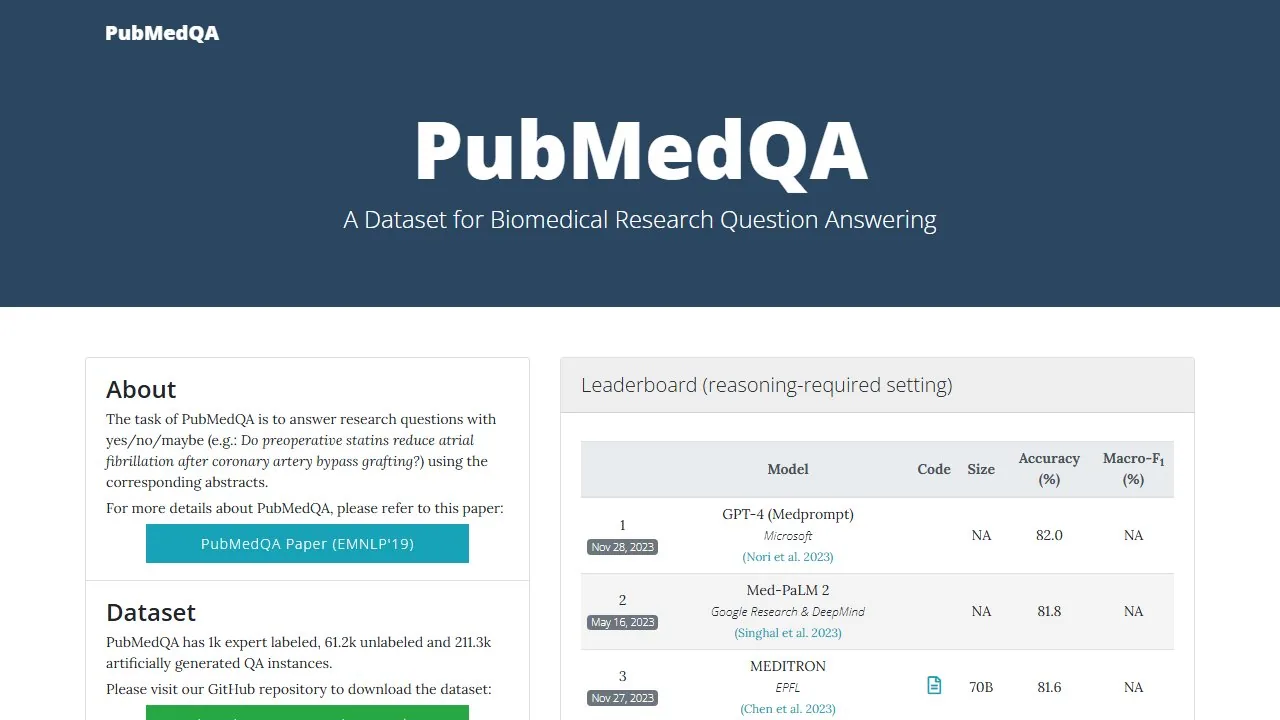
PubMedQA 是全球生物医学自然语言处理(BioNLP)与临床医学 AI 领域极负盛名的专业级问答数据集与基准评测体系。在医疗健康领域,人工智能的回答关乎生命健康,对专业事实的准确性、循证医学证据的理解以及专业术语的辨析有着极其苛刻的要求。PubMedQA 完全基于全球最大的权威生物医学文献数据库“PubMed”中海量同行评议论文的真实摘要构建。每道题目都由一个真实的临床科研问题、对应的文献研究背景以及权威专家的严谨定论组成,成为衡量通用大模型与专业医疗大模型“循证医学理解力”的行业金标尺。
适用人群与典型场景
- 医疗大模型研发团队与算法工程师:全面检验自研医疗健康领域专属模型(如 BioGPT、Med-PaLM 等)的循证医学推理能力。
- 生物信息学与医学科研人员:开展高水平学术论文科研,对比前沿基座模型在专业文献阅读与结论推断上的准确率。
- 数字医疗科技企业与医院信息化团队:在临床决策支持系统(CDSS)选型中,依据 PubMedQA 真实表现挑选最靠谱的医学大模型。
- 医学高校师生与文献分析者:探索前沿自然语言处理在快速处理海量生物医学前沿文献上的实用价值。
核心功能与特色亮点
- 严格基于真实权威生物医学文献构建:所有问题与上下文全部取自 PubMed 收录的高质量同行评议学术期刊论文摘要。
- 专业的“循证结论推断”三元决策任务:要求模型根据文献实验证据,准确回答“yes(是)”、“no(否)”或“maybe(可能/证据不足)”。
- 高质量专家人工标注黄金子集(PQA-L):由资深生物医学专业人员对核心题目进行逐题细致核验,保障评测绝对权威。
- 全方位衡量深层医学逻辑推演能力:要求模型必须穿透复杂的实验对照组数据、统计学 p 值与临床终点指标,推导出正确结论。
- 完全透明开源的数据集与排行榜体系:在 GitHub、Hugging Face 与 Papers with Code 上全球公开,支持全球学者自由下载与竞技。
如何快速上手 PubMedQA?(使用教程)
访问环境与使用门槛:全球公开学术资源,支持跨平台使用;数据集完全开源,可通过 Hugging Face Datasets 或 GitHub 快速获取。
- 访问 PubMedQA 官方主页与榜单:打开 pubmedqa.github.io 官网,查看当前全球顶尖医学模型与基础模型的最新跑分榜。
- 一键加载开源评测数据集:在 Python 环境中通过一行代码快速加载:
load_dataset("pubmed_qa", "pqa_labeled")。 - 提取上下文与临床研究问题:获取每条样本中的
context(论文摘要正文)与question(待回答的临床医学核心议题)。 - 运行模型推理并获取预测结论:让待测模型基于文献上下文进行逻辑推断,输出最终结论及说理逻辑。
- 评估准确率(Accuracy)与宏 F1 值:运行官方评估脚本,计算模型在专业三元分类上的准确率并对比全球 SOTA 记录。
收费标准与版本差异(产品价格)
PubMedQA 遵循国际生物医学学术界纯粹的非盈利开源宗旨:
- 完全免费开源(Open Source):数据集、专家标注样本与评测脚本 100% 永久免费向全球所有学术机构与个人开放。
客观评价与选型建议
- 核心优势:全球医学 AI 领域被引用最广泛、认可度最高的循证问答基准;考题完全来自真实论文,医学专业性极度硬核。
- 局限与权衡:主要侧重于基于英文文献摘要的循证推断,对于中文临床门诊多轮医患对话等本土化场景需结合本土医疗基准。
- 替代方案参考:通用跨学科英文基准可参考 MMLU;中文医疗多任务评估可参考 C-Eval 临床医学细分模块。


0 条评论
暂无评论,来抢沙发。